

서론
선행연구
1. DRT 수요 연구
2. 계층적 베이지안 모형
3. 교통 수요 예측의 내재적 불확실성 및 정책 의사결정 지표
4. 선행연구 종합 및 본 연구의 차별성
분석 방법론
1. 분석 과정
2. 건물 용도별 군집화
3. 도심/촌락 지역 군집화
4. 계층적 베이지안 허들 감마 회귀 분석(Hierarchical Bayesian Hurdle Gamma Regression)
연구자료 수집 및 기초분석
1. 연구의 범위
2. 연구자료 수집
3. 기초분석
분석 결과
결론
서론
수요대응형 대중교통(Demand-Responsive Transit, DRT)은 고정 노선 대중교통 서비스를 대체하거나 유연한 운행으로 기존 대중교통 노선망을 보완하기 위해 전국적으로 도입이 확산되고 있다. 전국 지자체에서는 대중교통 서비스가 열악한 지역 주민의 이동권 보장을 위해 DRT를 통한 벽지 교통 서비스 체계 구축을 추진하고 있다(Park and Jung, 2019). 또한, 도심 지역에서도 기존 대중교통 수단보다 시간적・공간적 접근성을 향상시키고 유동적 운행을 할 수 있다는 장점으로 미래 교통 분야에서 관심이 높다(Ahn, 2022). 이러한 흐름 속에서 DRT 운영의 지속 가능성을 확보하기 위해 신규 사업 지역을 합리적으로 선정하고, 지역별 수요 수준에 부합하는 적정 차량 규모를 결정하는 것이 중요한 과제다. 그러나 DRT 서비스는 일부 지자체에서 시범적으로 운영되고 있어 기존 대중교통과 달리 전국 단위에서의 수요 정보가 축적되어 있지 않으며, 이로 인해 신규 지역을 대상으로 한 수요 판단은 여전히 불확실성에 크게 의존하고 있다. 따라서 본 연구에서는 전국 단위의 DRT 수요 추정 모형을 제시하여 사업 지역 우선순위를 도출하고 적정 차량 운영 규모 산정을 지원하고자 한다. 다만, 현재 국내 DRT는 대부분 농어촌 및 중소도시를 중심으로 운영되고 있어 수도권 등 대도시의 DRT 운영 데이터 확보에는 한계가 있다. 따라서 본 연구에서는 전국 농어촌 및 중소도시를 중심으로 DRT 수요 추정 모형을 구축하고자 한다.
교통수단에 대한 수요 예측은 본질적으로 높은 불확실성을 내포하고 있으며, 특히 운영 이력이 충분히 축적되지 않은 DRT와 같은 신교통수단에서 이러한 문제가 심화될 수 있다. Takano and Morimoto(2012)는 일본 다카네자와정의 DRT 사례에서 설문자료 기반 예측 이용자 수가 실제 이용자 수의 약 2배 수준으로 나타나 과대 추정이 발생했음을 보였다. 이는 DRT와 같은 신교통수단은 이용 경험이 제한된 서비스로서 단순한 서비스 공급만으로 수요가 형성되기보다 초기 신뢰나 사회적 영향과 같은 심리적, 사회적 요인이 이용 의도에 중요한 영향을 미치기 때문이다(Pak et al., 2023).
이러한 불확실성 때문에 교통 수요 예측 모형은 정확한 예측값이 아니라 대안 비교 및 정책 평가 등 정책 의사결정 지원 목적의 다양한 지표를 제공해야 한다(Transportation Research Board, 2007). 따라서 본 연구에서는 DRT 수요 모형을 평가하기 위해 평균 절대 오차(Mean Absolute Error, MAE)와 같은 점 추정치를 기반으로 한 정확성 지표보다는 순위 기반 지표를 통해 정책적 우선순위 결정을 돕고자 했다.
또한, 본 연구에서는 좌표 데이터로 수집되는 DRT 호출 이력 및 건물 용도 데이터와 격자 단위로 수집되는 사회경제 데이터의 장점을 극대화하고 공간의 세부 특성을 최대한 반영하기 위해 읍면동과 같은 행정 구역 단위가 아닌 미시 격자 단위로 모형을 구축했다. 미시 격자 기반 모형은 지역의 세부 구조를 더 잘 포착할 수 있으며, 통행 패턴을 더 세밀하게 나타내기 때문이다(Zhang et al., 2021). 이러한 미시 격자의 해상도는 건물 용도를 기반으로 공간을 군집화하여 DRT 이용 수요를 추정하려는 본 연구의 접근 방식에 적합하다. 따라서 본 연구에서는 100m, 500m, 1km의 미시 격자 단위로 모형을 구축하여 분석했으며 모형 예측 결과를 바탕으로 100m 격자 단위 모형을 최종 선택했다.
본 연구는 DRT 이용 수요 예측을 위해 계층적 베이지안 모형을 활용했다. 계층적 모형은 서로 다른 집단 간의 차이를 모형에 반영하면서도 상위 수준의 분포를 통해 집단 간 정보를 공유할 수 있는 장점을 가진다(Gelman and Hill, 2006). 이러한 특성은 DRT와 같이 지역의 사회경제적 속성, 도시 구조, 토지 이용 등에 따라 상이한 수요 패턴(Wang et al., 2023a)을 보이는 자료를 분석하는 데 매우 유용하며, 군집화된 집단 간의 이질성을 반영한 모형 구축이 가능하다. 또한, 계층적 베이지안 모형은 집단 간 정보를 공유함으로써 과도한 추정 변동성을 완화하고 보다 안정적인 추정을 가능하게 한다(Gelman et al., 2013). 특히 개별 단위의 데이터가 제한적인 경우에도 상위 수준의 정보를 활용하여 신뢰도 높은 모수 추정이 가능하다는 장점을 가진다.
이에 따라 본 연구의 기여는 다음과 같다. 기존 연구들은 주로 특정 지역을 기반으로 지역에 특화된 DRT 수요를 분석하고 예측의 점 추정치 정확도 향상에 초점을 두어 왔다. 이에 반해 본 연구는 전국 농어촌 및 중소도시를 중심으로 DRT 수요를 추정할 수 있는 일반화된 모형을 제시하고 정책적 우선순위 도출에 활용할 수 있는 분석 틀을 제시했다는 점에서 차별성을 가진다. 또한, 행정 구역이 아닌 미시 격자 단위에서 분석하고 건물 용도를 기반으로 공간을 군집화함으로써 공간적 이질성과 세부적인 격자의 역할을 보다 정밀하게 반영했다. 방법론적으로는 계층적 베이지안 모형을 적용해 지역 간 이질성을 고려하면서도 군집 간 정보 공유를 통해 추정의 안정성을 확보했다.
선행연구
1. DRT 수요 연구
DRT 도입이 활성화되며 많은 연구들은 DRT 수요에 영향을 미치는 요인을 연구해 왔다. 예를 들어, Imhof and Blattler(2023)는 스위스 베른의 두 농촌 지역에서 운영 중인 DRT 서비스(mybuxi)의 통행 데이터를 분석해 인구 규모, 철도역과의 거리, 대중교통 서비스 수준, 음식점 유무 등이 수요에 유의미한 영향을 미침을 확인했다. 또한, 이 연구에서는 공간적 전이 가능성에 대해 검토했는데 한 지역에서 학습된 모형을 다른 지역에 적용해 수요 예측 성능을 비교했다. 그 결과, 전이 모형의 예측 성능은 상대적으로 낮았지만, 전이 후에도 인구 규모와 철도역과의 거리가 공통적으로 중요한 변수임을 확인했다. 이는 DRT 수요가 단일한 공간적 구조를 따른다고 가정하긴 어렵지만, 일부 변수가 공통적으로 중요한 설명 변수로 작용할 수 있음을 시사한다.
Lee et al.(2023)은 영종도에서 DRT를 운영한 I-MOD 사업자의 운행 이력을 이용해 어떤 변수가 DRT 통행에 영향을 미치는지 분석했다. 다른 연구들이 인구, 종사자 수와 같은 변수를 활용한 것과 달리, 해당 연구는 출발지와 도착지의 토지 이용별 면적을 이용했다. 분석 결과, 상업지는 출발지, 도착지에 관계없이 DRT 수요를 높이는 것으로 나타났고 주거지나 공업지는 시간에 따라, 혹은 출발지, 도착지인지에 따라 영향력이 다르게 나타남을 확인했다. 이는 토지 이용과 DRT 수요 간 상관관계가 있을 가능성을 시사하는 한편, 인구, 종사자 수와 같은 사회경제 데이터를 사용하지 않았기 때문에 실질적인 통행 유발 요인을 포괄적으로 분석할 필요가 있음을 시사한다.
유사하게 Wang et al.(2023b)도 토지 이용 변수를 사용했다. 중국 대련 지역을 대상으로 분석했으며 연구에서는 인구 밀도, 고용 밀도, 토지 이용 혼합도, 도로 연결성, 대중교통 접근성, 주요 목적지 접근성 등으로 구성된 지표를 활용해 이용자의 서비스 구독 빈도를 설명했다. 분석 결과, 주거 인구 밀도가 높고 고용 밀도가 낮은 지역, 주거용 토지 이용 비율이 높은 지역, 도로 연결성과 주차 공급이 상대적으로 낮은 지역, 그리고 도심 업무 중심지와의 거리가 먼 지역에서 DRT 이용 빈도가 높게 나타났다.
2. 계층적 베이지안 모형
계층적 베이지안 모형(Hierarchical Bayesian Model)은 서로 다른 집단 또는 공간 단위에 속한 자료를 동시에 분석하기 위한 통계적 접근 방법으로 널리 활용되고 있다. 이 모형은 집단 간 정보를 공유하는 부분적 풀링 구조를 통해 표본 수가 적은 집단에서도 안정적인 모수 추정을 가능하게 한다(Gelman and Hill, 2006).
교통 분야에서도 계층적 베이지안 모형은 다양한 분석에 활용되고 있다. Pitombeira-Neto et al.(2020)은 교통 네트워크에서 일별 변동하는 OD 통행 수요를 추정하기 위해 동적 계층적 베이지안 모형을 제안했다. 해당 연구에서는 링크 교통량 데이터를 활용해 OD 수요의 시간적 변화를 추정했으며, 계층적 구조를 통해 교통 네트워크 내 수요 변동성을 효과적으로 반영했다. Boilé et al.(2010)은 화물 운송 수요 분야에서 화물 운송 교통량의 자료 부족 문제가 있을 때 기존 회귀 모형이 과적합과 변수 간 상관성 문제로 예측 성능이 저하될 수 있음을 지적했다. 이를 해결하기 위해 계층적 베이지안 네트워크 모형을 적용해 확률적 변수 선택을 활용하고 사전 정보를 통해 계수 추정을 안정화하며, MCMC(Markov Chain Monte Carlo) 기반 추정을 통해 제한된 자료에서도 보다 안정적인 화물 수요 예측이 가능함을 보였다. 연구 결과, 제안된 모형은 기존 4단계 모형 대비 검증 데이터에서 일관되고 안정적인 예측 성능을 보였다.
Kidando et al.(2019)는 계층적 베이지안 구조를 이용해 고속도로의 교통 상태를 분석하는 모형을 제안했다. 실제 고속도로에서는 시간에 따라 교통 상태가 유사하게 변하면서도 차로에 따라 다르게 나타나는데 기존 모형은 이러한 이질성을 충분히 반영하지 못한다는 점을 지적했다. 이에 따라 해당 연구는 차로를 중앙에 가까운 차로, 중앙 차로, 외곽 차로로 분류하고 계층적 베이지안 모형을 구축했다. 이를 통해 차로 간의 이질성을 반영하면서도 상위 수준의 분포를 통해 집단 간 정보를 공유하는 계층적 베이지안 모형의 장점을 활용했으며 기존 모형 대비 차로별 교통 상태를 보다 정교하게 설명할 수 있음을 보였다.
3. 교통 수요 예측의 내재적 불확실성 및 정책 의사결정 지표
교통 수요 예측 모형은 주로 정량적인 수요 예측값을 결과로 산출하지만, 신규 도입 교통 서비스나 운영 이력이 충분히 축적되지 않은 교통수단에서는 예측값과 실제 수요 간 차이가 크게 나타날 수 있다.
특히, DRT와 같은 신교통수단은 기존에 이용 경험이 부족한 서비스이기 때문에 단순한 서비스 제공만으로 수요가 형성되기보다는 수단에 대한 초기 신뢰나 사회적 영향과 같은 심리적, 사회적 요인 역시 중요하게 작용하기 때문이다. Pak et al.(2023)은 대한민국의 19세~64세 인구를 대상으로 DRT 이용 의사를 분석한 결과, 초기 신뢰와 성능 기대, 사회적 영향 등이 이용 의사에 유의미한 영향을 미치는 것으로 나타났다. 이는 지역의 잠재적 이동 수요가 그대로 실제 DRT 이용으로 이어지는 것이 아니라 서비스에 대한 인식과 평가가 긍정적으로 형성될 때 비로소 실제 수요로 전환될 수 있음을 시사한다. 그러나 이러한 요인들은 정량화 및 모형화가 어렵기 때문에 신교통수단에서 수요 예측은 불확실성이 심화될 가능성이 크다. 또한, DRT 수요 예측의 어려움은 수요의 희소성에서도 비롯된다. DRT는 저수요 지역의 대중교통 서비스 한계를 보완하기 위해 도입되는 경우가 많고, 실제 호출 수요가 시공간적으로 산발적으로 발생해 수요 예측의 불확실성을 심화시킨다(Lee et al., 2024). 실제 DRT 도입 사례에서도 예측 수요와 실제 수요 간 차이가 보고됐다. Takano and Morimoto(2012)는 일본 다카네자와정에서 운영된 DRT 사례를 대상으로 실제 이용자 수와 예측 이용자 수의 차이를 분석하였다. 해당 연구에서는 설문자료를 바탕으로 구축한 수요 예측 결과, 월간 이용자 수가 6,503명으로 산출되었으나, 이는 실제 이용자 수보다 약 3,000명 많고 실제 값의 약 2배에 해당하는 수준으로 과대 추정됐음을 보였다.
이에 따라 점 추정치 기반의 절대적 수요 지표 대신 상대적 수요 지표를 활용해 정책 결정을 돕는 연구도 진행되고 있다. Alsaleh and Farooq(2021)은 DRT 이용량을 연속적인 값으로 직접 예측하기보다 수요 수준에 따라 낮음, 보통, 높음의 세 범주로 구분하여 종속변수를 설정하고 분석을 수행하여 수요 예측의 불확실성을 완화하고자 했다. 유사하게 Yao(2007)도 대중교통 이용 수요를 평가하기 위해 이용 수요 수준 지표를 제안하고, 이를 기반으로 지역별 이용 수요를 추정함으로써 수요 예측의 불확실성을 고려한 대중교통 서비스 지역을 식별했다.
4. 선행연구 종합 및 본 연구의 차별성
DRT 수요를 추정하거나 수요 요인 변수를 분석한 연구는 진행되고 있으나 대부분 특정 지역에 국한됐다. 전역적 수요 추정이나 모형을 다른 지역에 적용하는 전이 가능성을 살펴본 연구는 부족한 실정이다. 따라서 본 연구에서는 전국의 농어촌 및 중소도시 지역의 DRT 수요를 추정하는 모형을 구축하여 농어촌 및 중소도시에서의 DRT 도입 정책 결정을 지원하고자 한다.
모형을 구축하기 위해 선행연구를 종합하면, 인구, 대중교통 관련 변수가 유의미한 영향을 미침을 확인할 수 있었다. 특히, 토지 이용 체계는 DRT 수요에 영향을 미칠 수 있는 주요 요인으로 시사됐으나 기존 방식은 도시의 실질적인 구조보다는 대략적인 구조를 반영했다는 한계가 있다. 지역의 특징을 구체적으로 반영하기 위해서 본 연구는 건물의 주용도를 이용해 지역의 실질적인 용도를 파악하고, 각 용도별로 모형을 계층적 구조로 구축했다. 또한, 대중교통 예측 모형은 정책적 근거를 위해 단순한 예측력보단 구조적 해석이 가능한 모형을 구축하는 것이 중요하기에, 기계학습 모형이 아닌 통계적 모형을 활용해 수요를 추정했다. 본 연구는 신교통수단의 수요를 추정하는 만큼 운영 데이터 확보에 한계가 있다. 따라서 제한된 자료 환경과 서로 다른 집단 간 차이가 존재함에도 모형이 안정적으로 추정되게 하는 계층적 베이지안 모형을 활용해 자료의 희소성 문제를 보완하고자 했다.
또한, 예측 오차가 불가피한 상황에서 점 추정치 기반 평가가 아닌 순위 기반의 예측 및 평가를 통해, 실질적인 DRT 도입의 정책적 우선순위를 제안하는 모형을 구축했다.
분석 방법론
1. 분석 과정
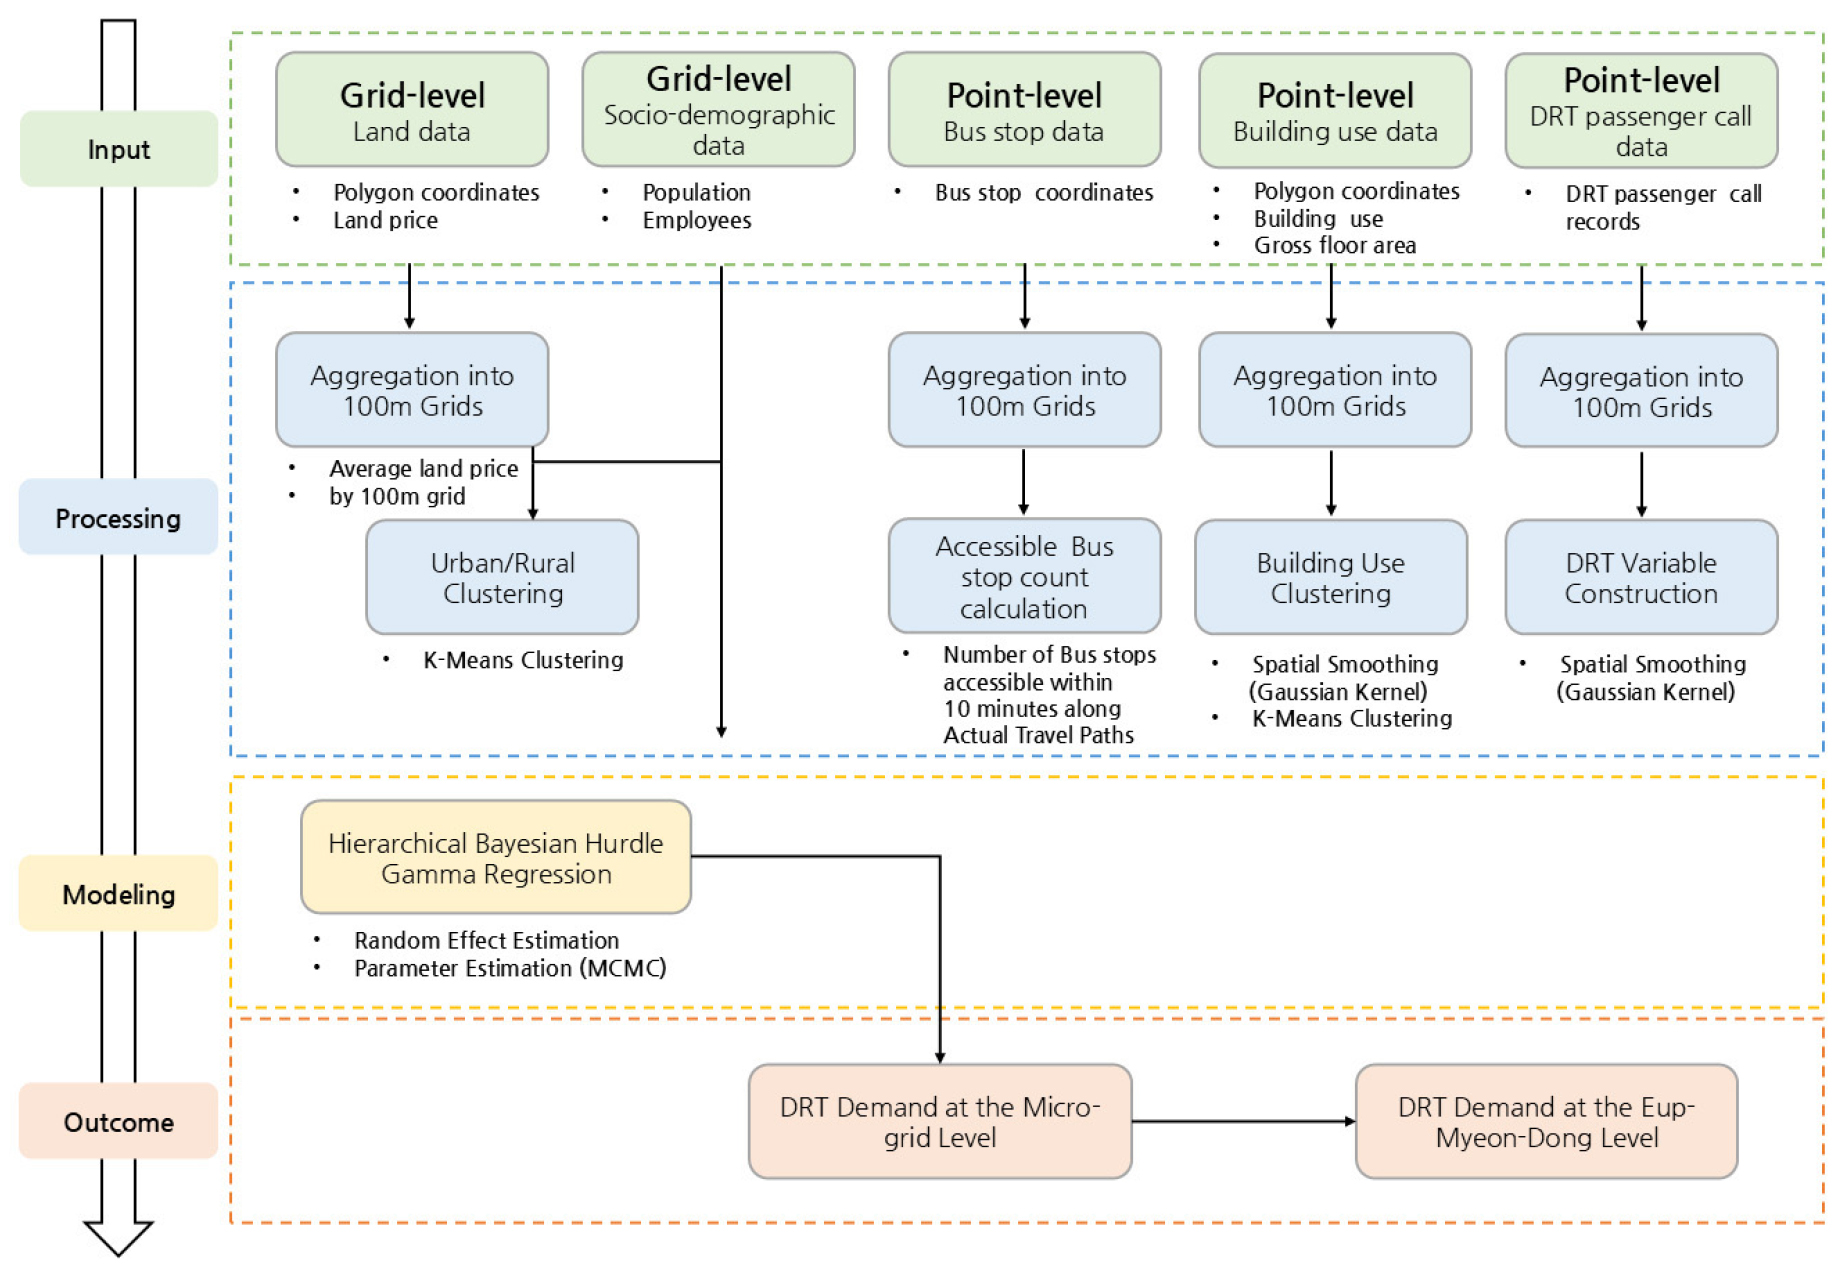
본 연구의 분석 과정은 서로 다른 특성을 가진 전국의 모든 농어촌 및 중소도시를 중심으로 일반화된 예측 성능을 확보할 수 있는 모형을 구축하는 것에 집중했다. 단순히 일반화에 그치지 않고, 수요 패턴에 유의미한 영향을 줄 수 있는 각 지역의 특성을 최대한 반영하고자 했다. 이를 위한 모형의 구축 과정은 Figure 1과 같다. 100m 격자별로 DRT 수요량을 추정했고, 해당 격자 내 건물의 주용도별 면적을 바탕으로 군집화했다. 군집화 결과를 토대로 DRT 운영 데이터를 가진 일부 지역을 대상으로 계층적 회귀 분석 모형을 구축하고, 이를 전국 지역에 확장 적용해 전국 단위의 DRT 이용 수요를 추정했다.
2. 건물 용도별 군집화
DRT 수요 분포 양상은 토지 이용과 밀접한 관련이 있다(Lee et al., 2023). 본 연구에서는 토지 이용과 DRT 수요가 단순한 선형 관계를 갖는 것이 아니라, 공간 기능에 따라 수요에 영향을 미치는 변수와 그 영향력의 크기가 달라질 수 있다고 판단하였다. 예를 들어 동일한 종사자 수를 가진 격자라도 주거 중심 공간, 상업 중심 공간, 산업 중심 공간에서는 통행 목적, 교통수단 선택 환경이 다를 수 있으며, 이에 따라 종사자 수가 DRT 수요에 미치는 영향도 다르게 나타날 수 있다. 따라서 본 연구에서 계층적 구조를 설정한 목적은 수요 규모가 큰 지역과 작은 지역을 구분하는 것이 아니라, 동일한 인구 및 종사자 규모가 주어지더라도 공간 기능에 따라 DRT 수요 형성 방식이 달라질 수 있음을 반영하는 데 있다. 이에 본 연구에서는 건물 용도 기반 군집을 인구와 종사자 수의 효과가 달라질 수 있는 공간적 맥락으로 설정하고, 인구와 종사자 수는 회귀 모형의 설명 변수로 직접 반영하였다.
따라서 본 연구에서는 격자의 주요 용도에 따른 수요 발생 행태를 모형에 반영하기 위해 격자 내부 건물들의 용도를 이용해 군집화했다. 먼저 건물 데이터의 주용도를 주거 용도(Residential), 상업 및 공공 서비스 용도(Commercial & Public Service), 공업, 창고 및 농업 용도(Industry, Warehouse & Agriculture), 기타 시설(Other Facilities)의 네 기능 용도군으로 재분류하였다. 이는 세부 건물 용도를 모두 개별 변수로 사용할 경우 용도 수가 많아 해석이 어려워져 비슷한 역할군으로 묶어 단순화하기 위한 절차이다. 상세한 분류 사항은 Table 1과 같다.
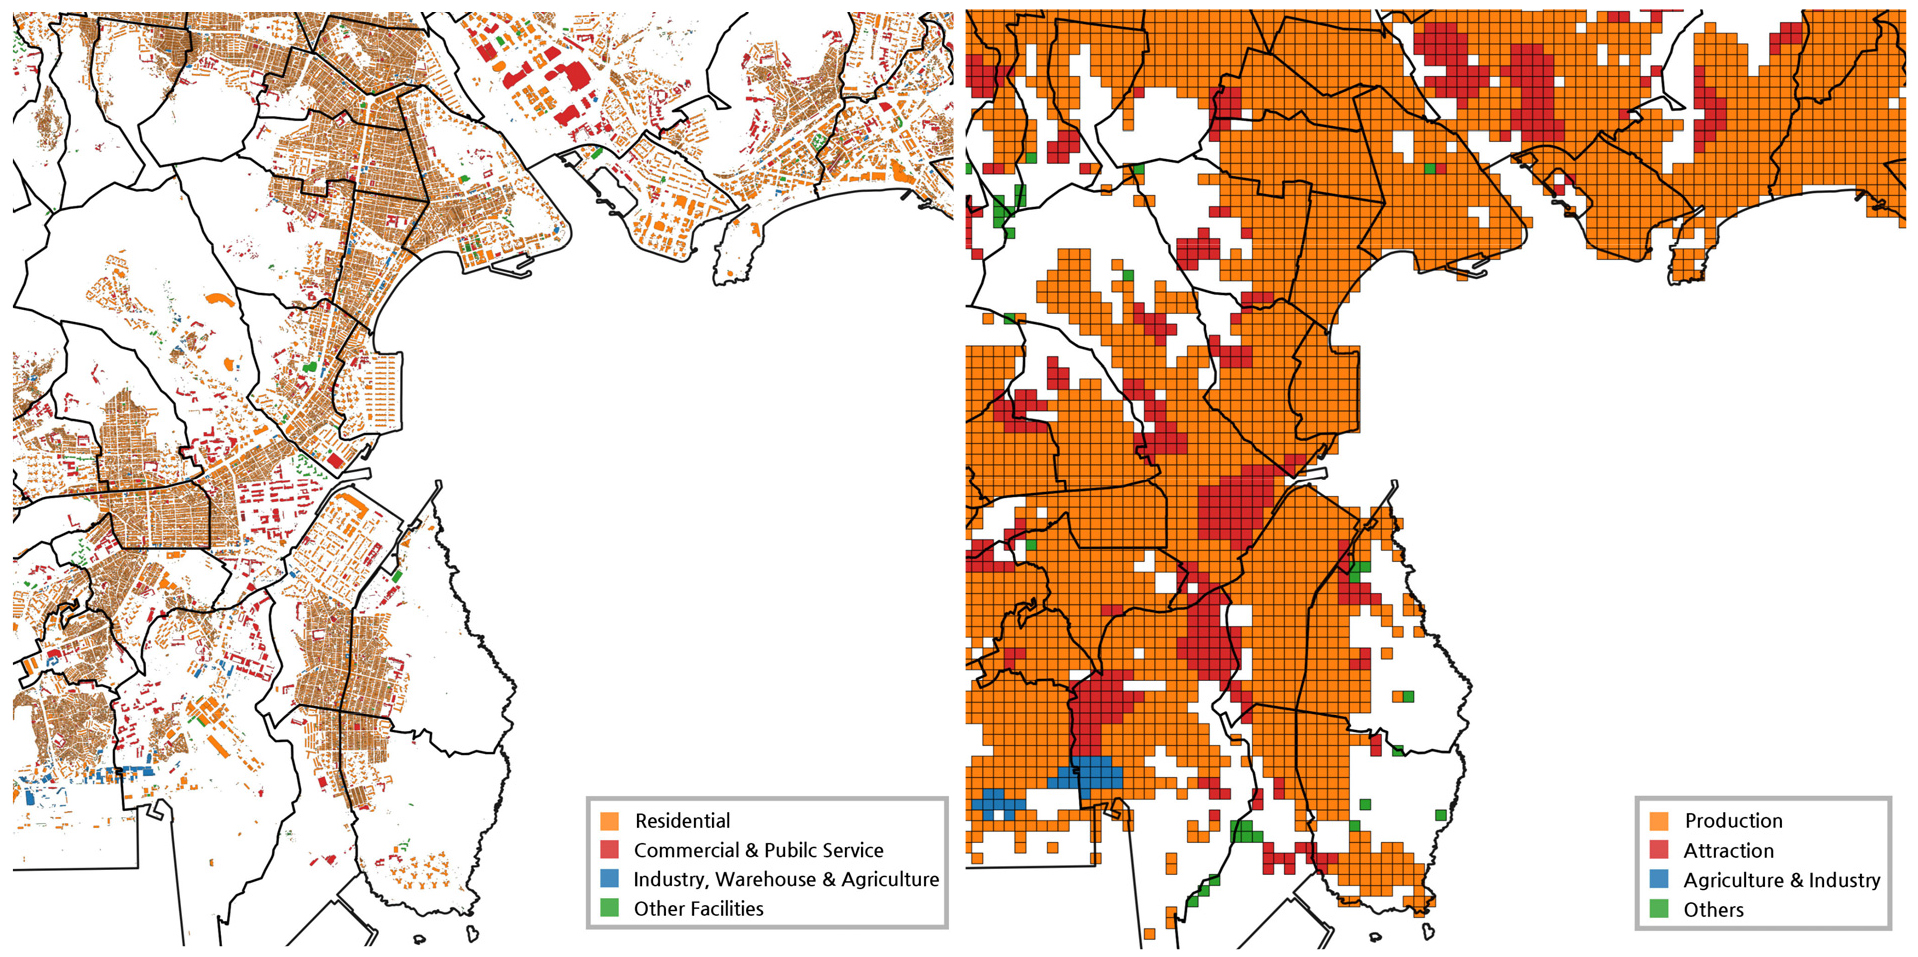
이 분류를 토대로 분류별 건물의 연면적을 계산해 각 격자에 할당하였다. 본 연구에서 사용한 건물 용도 데이터는 Figure 2(a)와 같이 개별 건물의 위치와 형태를 나타내지만, 본 연구의 분석 단위는 100m 미시 격자이므로 건물 단위의 용도 정보를 격자 단위의 공간 기능으로 변환해야 한다. 단순히 각 격자 내에서 가장 큰 연면적 비율을 차지하는 건물 용도군을 대표 용도로 지정할 경우, 대형 건물이 격자 경계를 넘어 분포하거나 인접 격자에 미치는 영향이 충분히 반영되지 못할 수 있다. 이를 보완하기 위해 본 연구에서는 가우시안 필터(Gaussian Filter)를 적용했다. 가우시안 필터는 인접 격자에 대해 거리 기반 가중치를 부여함으로써, 개별 건물의 영향이 주변 공간으로 연속적으로 분포하도록 하는 공간적 스무딩 기법이다(Zhang et al., 2026). 이는 대형 건물일수록 더 넓은 공간 범위에 영향을 미친다는 도시 공간적 직관과 부합하며, 건물 용도 효과를 단일 격자에 국한하지 않고 주변 격자에 점진적으로 확산시키는 역할을 한다. 가우시안 필터를 통해 격자 경계로 인한 추정 오차를 완화하고, 건물 용도 정보가 인접 격자에 자연스럽게 분산되도록 했다.
이렇게 계산된 용도별 연면적 비율을 바탕으로 K-means clustering을 사용해 군집화를 수행했다. 이때 최적의 군집 수(k)는 silhouette 값을 기준으로 결정했으며, 최종적으로 k=4로 설정했다. 최종 군집은 각 군집의 특성을 보고 판단하여 주거 용도 중심 군집은 통행생성지(Production), 상업 및 공공서비스 용도 중심 군집은 통행유인지(Attraction), 공업 및 창고 용도 중심 군집은 농공업지(Agriculture & Industry), 기타 시설 중심 군집은 기타(Others)로 명명하였다. Figure 2(b)는 부산 일부 지역의 군집화 결과를 시각화한 것이다. Figure 2(a)와 Figure 2(b)를 비교하면 군집화 결과가 개별 건물 용도 분포를 단순히 단일 용도로 나타낸 것이 아니라 해당 격자 및 인접 격자의 기능용도군의 연면적 비율 구성을 반영하여 격자를 구분하고 있음을 확인할 수 있다.
Table 1.
Mapping of detailed building-use types to four functional categories
3. 도심/촌락 지역 군집화
건물 용도 군집화와 더불어 각 격자가 도심 지역과 촌락 지역 중 어디에 속하는지를 구분하기 위해 전국의 미시 격자 단위에서 도심/촌락 군집화를 수행했다. 이는 지역 유형에 따라 교통 수요가 형성되는 방식이 다를 수 있기 때문이다. 일반적으로 교통 수요는 기존 교통수단으로부터의 전환 수요와 기존에 충족되지 못했던 이동이 새롭게 실현되는 유발 수요로 구성될 수 있다. 촌락 지역은 기존 대중교통 서비스가 제한적인 경우가 많아 신규 교통 서비스가 도입될 경우 유발 수요의 비중이 상대적으로 크게 나타날 가능성이 있다(Kim et al., 2026; Oh et al., 2026). 이러한 경우 DRT 수요는 주로 인구나 종사자 수와 같은 지역의 기본적인 활동 규모에 의해 설명될 수 있다.
반면, 도심 지역은 교통수단 선택이 비교적 다양한 공간적 맥락을 가지며, 기존 교통수단과의 경쟁 관계 속에서 수요가 형성될 가능성이 높다. 따라서 동일한 인구 및 종사자 규모를 가진 지역이라 하더라도 기존의 교통 서비스 접근 수준에 따라 DRT의 상대적 효용이 달라질 수 있다. 이러한 가설 아래, 본 연구의 모형에서는 도심 지역에 한하여 접근 가능한 버스 정류장 수를 변수로 모형에 추가 반영했다. 접근 가능한 버스 정류장 수는 기존 버스 서비스 접근 수준을 간접적으로 나타내는 지표로 볼 수 있으며, 정류장 수가 많을수록 기존 대중교통과의 경쟁 가능성이 커져 DRT 이용으로의 전환 수요가 일부 감소할 가능성이 있다고 판단했다. 다만, 접근 가능한 버스 정류장 수는 버스 서비스의 실제 운행 횟수나 배차간격을 직접 반영하지는 못하므로 실질적인 대중교통 접근성 수준을 완전히 나타내지는 못할 수 있다. 그러나 100m 격자 단위에서 정류장별 운행 횟수나 배차간격 데이터를 전국적으로 수집하는 데 한계가 있어 대안으로 접근 가능한 버스 정류장 수를 이용했다.
이러한 변수 적용을 위해 각 미시 격자가 도심 또는 촌락의 공간적 맥락 중 어디에 속하는지를 구분할 필요가 있었으며, 이에 따라 추가적인 보조 군집화를 수행했다. 군집화에는 각 격자의 인구와 종사자 수를 합한 값과 토지 가격을 사용했다. 인구 및 종사자 규모는 해당 지역의 활동 밀도와 이용 강도를 나타내는 지표이며, 토지 가격은 토지 이용 강도와 경제적 중심성을 반영하는 변수로 해석할 수 있다. 일반적으로 인구 및 종사자 규모가 크고 토지 가격이 높은 지역은 도시의 주요 활동 중심지로 기능하는 경우가 많으며, 이러한 지역은 높은 이동 수요를 수용하기 위해 다양한 대중교통 서비스가 집중되는 경향이 있다. 반대로 활동 밀도와 토지 가격이 낮은 지역은 상대적으로 교통 수요 밀도가 낮아 대중교통 공급 수준이 제한되는 경우가 많다. 따라서 인구·종사자 규모와 토지 가격은 해당 공간이 대중교통 경쟁 환경이 형성된 도시형 공간인지, 혹은 교통 공급이 제한된 비도시적 공간인지 구분하는 데 활용될 수 있다.
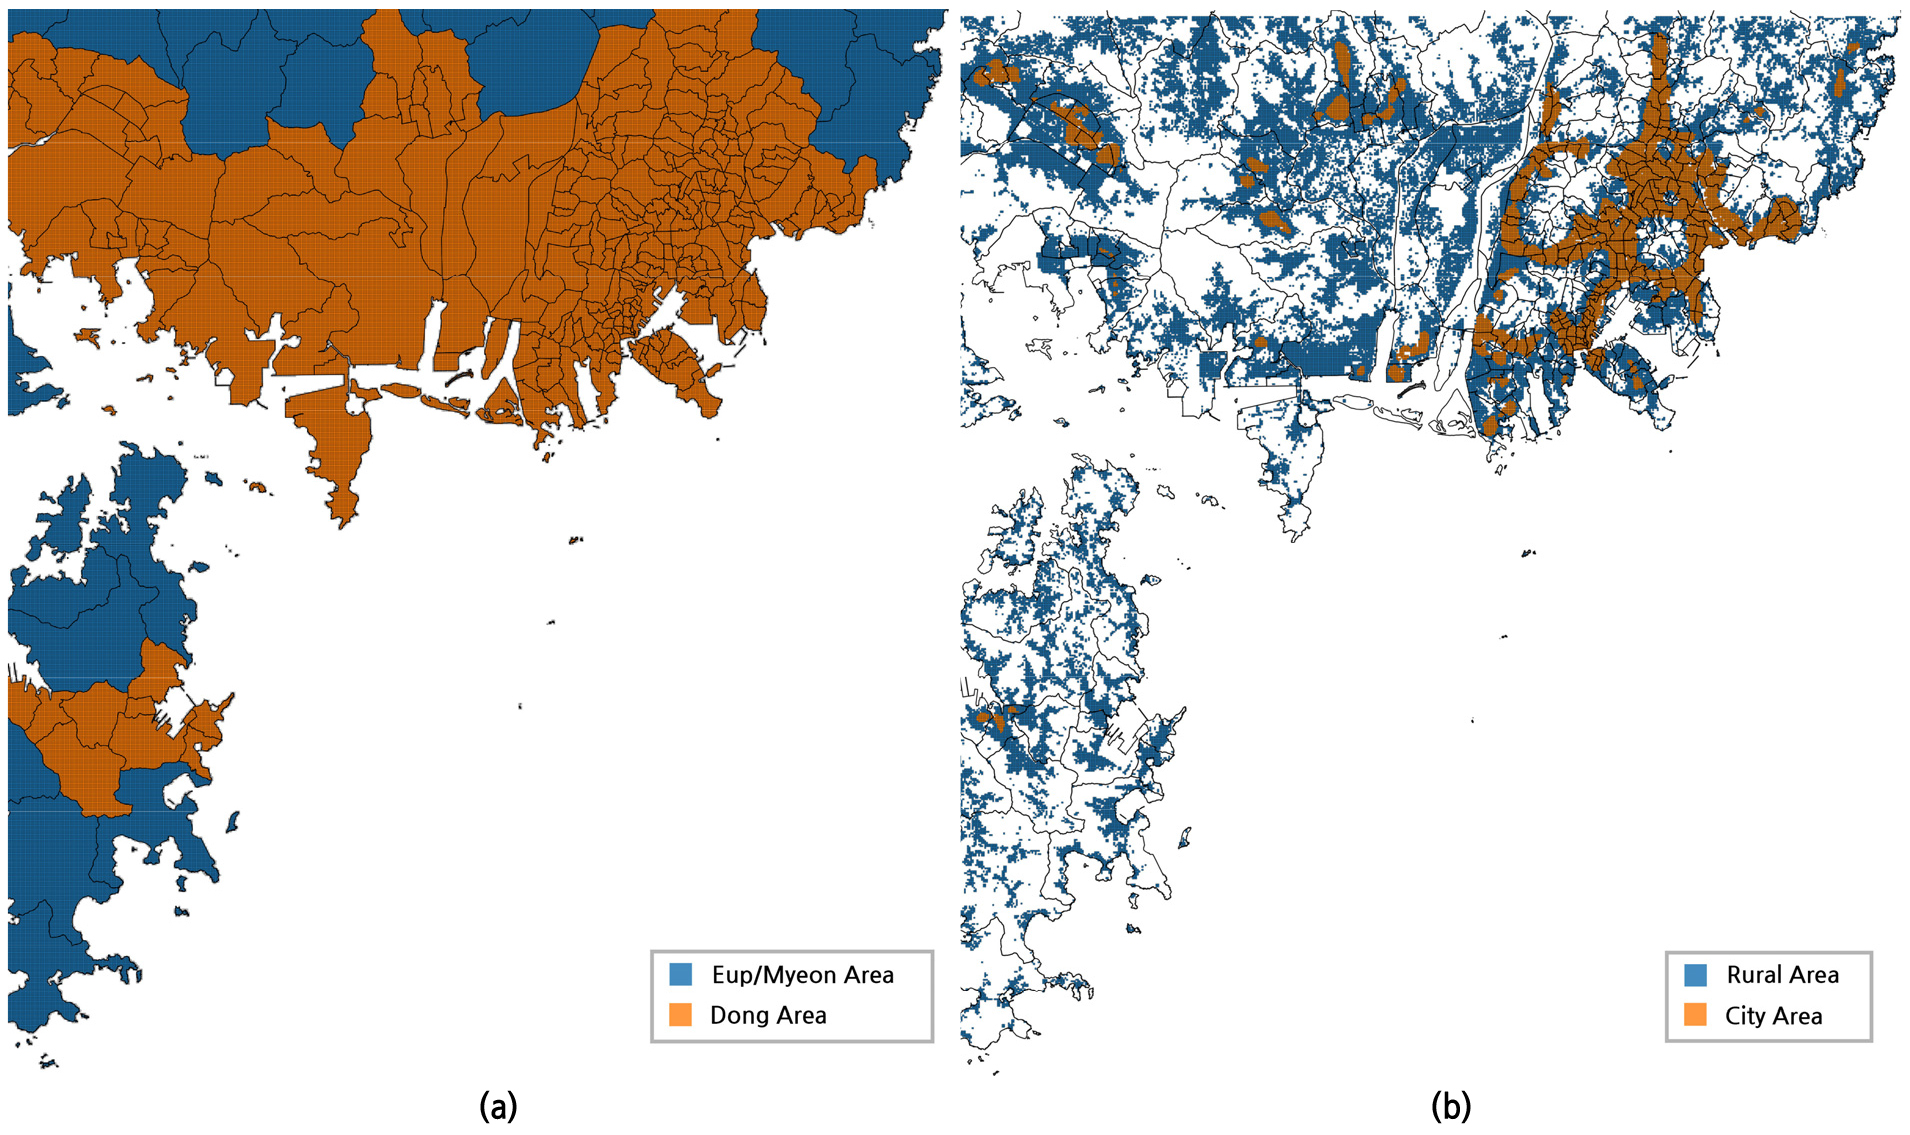
이를 바탕으로, 본 연구에서는 미시 격자 단위에서의 군집화를 보다 안정적으로 수행하기 위한 방법을 적용했다. 본 연구는 미시 격자 단위의 분석을 수행하기 때문에 격자 내부가 도로, 공원 등으로 구성되어 인구나 종사자 수가 집계되지 않는 경우가 발생할 수 있다. 이러한 경우 실제 주변 지역의 공간적 특성을 충분히 반영하지 못할 가능성이 있다. 이를 보완하기 위해 각 격자를 중심으로 반경 500m 범위 내의 인구 및 종사자 수를 집계하여 군집화를 수행했다. 이를 통해 미시 격자 단위에서도 실제 공간적 환경을 보다 적절히 반영한 도심/촌락 분류가 가능하게 했다. 군집화에는 K-means clustering을 사용하였으며, silhouette 값을 기준으로 최적의 군집 수(k)를 2로 결정했다. 이에 따라 각 군집을 도심과 촌락으로 구분하였다. Figure 3(a)는 경상남도 지역을 행정 구역상 ‘읍’, ‘면’ 지역과 ‘동’ 지역을 구분한 결과이며 Figure 3(b)는 지가와 500m 반경 내 인구 및 종사자 수를 이용하여 100m 격자 단위로 도심 및 촌락 지역을 군집화한 결과이다. 두 결과는 일부 지역에서 유사하지만, 완전히 일치하지는 않는다. 이는 두 분류가 서로 다른 개념을 반영하기 때문이다. 행정 구역 기반 분류는 제도적 경계를 기준으로 넓은 지역을 일괄적으로 구분하는 반면, 본 연구의 군집화는 각 격자 주변의 활동 밀도와 경제적 중심성을 기준으로 공간 맥락을 구분한다. 따라서 행정 구역상 ‘동’으로 지정된 지역이라도 활동 밀도와 지가가 낮은 외곽 격자는 촌락 군집으로 ‘읍’, ‘면’ 지역이라도 활동 밀도가 높은 격자는 도심 군집으로 분류될 수 있다. 본 연구에서는 도심/촌락 구분의 목적이 교통수단 선택 환경을 반영하기 위해 실제 미시 격자 단위의 활동 밀도와 경제적 중심성을 반영하는 것이 더 중요하다고 판단하여 행정 구역 분류가 아닌 군집화 결과를 활용하였다.
4. 계층적 베이지안 허들 감마 회귀 분석(Hierarchical Bayesian Hurdle Gamma Regression)
본 연구에서는 DRT 수요를 설명하기 위해 계층적 베이지안 허들 감마 회귀 모형을 구축했다. 분석에 사용한 DRT 이용 데이터는 호출 좌표 형태로 제공되기에, 이를 미시 격자 단위로 집계하여 격자별 이용량을 산출했으며 이용량은 월평균을 기준으로 했다. 또한, 운영사에서 제시한 서비스 운영 행정 구역을 바탕으로 이용량이 0인 격자를 산출했다. 그러나 정확한 행정 구역이 제시되지 않은 지역이 존재했으며 제시된 행정 구역 밖에서 이용 내역이 존재하는 등 서비스 운영 지역을 정확하게 구분하지는 못했다. 따라서 이용량이 0으로 나타나는 격자가 실제로 수요가 존재하지 않는 지역인지, 또는 단순히 서비스가 제공되지 않는 지역인지를 정확히 판별해 내지는 못했다. 이러한 이유로 실제 수요가 존재해야 할 곳인데 수요가 0으로 지정된 격자가 있을 수 있다는 한계를 가진다. 그러나 이용량이 0인 격자를 모두 분석 대상에서 제외하는 것은 모형이 수요가 없는 격자를 구분해 내지 못하고 DRT와 같은 저수요 교통수단에서 이러한 점은 과대 추정 문제를 심화시킬 수 있기에 제시된 행정 구역으로라도 운영 경계를 근사하는 것이 더 타당하다고 판단하였다.
또한, 격자 경계 인근에서 발생한 호출의 경우 실제 수요가 발생한 위치와 탑승이 이뤄진 격자가 다르게 나타날 수 있다. 이러한 공간적 불연속성을 완화하기 위해 DRT 이용량에 가우시안 필터를 적용했다. 이러한 과정에서 종속 변수는 양의 연속형 변수로 변환된다.
한편, 본 연구에서는 건물 용도별 네 개의 군집에서 모형을 구축해야 하는데 이때 각 군집별로 독립된 모형을 적용할 경우, DRT 이용 자료가 소규모로 분할되고 모형별로 활용 가능한 자료의 규모가 감소하여 일반화 가능성이 저하될 수 있다. 따라서 본 연구에서는 계층적 구조 모형을 사용해 이를 보완했다. 또한, 계층적 모형을 표현하는 데 적합하며 자료 수가 군집별로 불균형할 때 안정적인 베이지안 모형을 사용했다. 마지막으로 DRT 데이터는 값이 0 또는 양수이며 우측 꼬리가 긴 분포를 나타내는 것으로 확인됐다. 대부분의 격자는 낮은 DRT 수요를 보일 것이지만, 소수의 핵심 지역은 높은 수요를 보일 것이기 때문이다. 이러한 분포 특성으로 허들(Hurdle) 모형을 적용해 이용량이 존재할지 여부에 대해서는 이항 모형을, 이용량이 존재하는 곳에서는 양의 연속형 변수의 우측 왜도 분포를 설명하는 데 널리 사용되는 감마(Gamma) 분포를 이용해 추정하는 것이 적합하다. 따라서 본 연구에서는 계층적 베이지안 허들 감마 회귀 모형을 적용하여 DRT 이용량을 추정하였다.
모형의 변수는 인구 수, 종사자 수, 접근 가능한 버스 정류장 수를 사용했다. 인구 수가 많을수록, 종사자 수가 많을수록 DRT 수요가 클 것이라고 가정했으며 반대로 접근 가능한 버스 정류장 수는 많을수록 DRT 수요가 작아질 것이라고 가정했다. 접근 가능한 버스 정류장 수가 많다는 것은 대체적으로 그 지역의 대중교통 접근성이 좋음을 의미하며, 대체 교통수단이 많은 지역에서는 DRT 이용량이 상대적으로 낮게 나타날 가능성이 크기 때문이다.
이러한 변수 구성은 모형 설계 과정에서 다양한 사회경제 변수와 교통 관련 변수를 함께 검토한 후 결정됐다. 예를 들어 평균 소득이나 지가와 같은 경제적 변수와 버스 이용량, 평균 연령, 자동차 보유율 등과 같은 이동 행태 관련 변수들도 모형에 포함했으나 통계적으로 유의한 효과를 보이지 않았으며, 일부 변수는 모형의 예측 성능을 오히려 저하시켰다. 이는 데이터의 수가 제한적이며, 전국 단위 전역 모형을 구축해야 하는 연구 설계의 영향도 있는 것으로 판단된다. 이러한 검증 과정을 거친 결과, 인구와 종사자 수가 가장 안정적으로 DRT 수요와의 관계를 설명하는 변수로 나타났으며 모형의 예측 성능 역시 가장 우수했다.
따라서 최종적으로 인구와 종사자 수, 접근 가능한 버스 정류장 수를 설명 변수로 선정했다. 접근 가능한 버스 정류장 수 변수는 실질적인 대중교통 접근성을 나타낼 수 있게 단순히 직선거리가 아닌 각 격자 중심점을 기준으로 실제 10분 이내 접근 가능한 버스 정류장 수를 집계했다. 일반적으로 버스 시설의 영향권이라고 판단하는 도보 8분에, 격자 중심점을 기준으로 했으므로 이를 보정하기 위한 2분을 더했다(Transportation Research Board, 2013; The Seoul Institute, 2020). 도보 시간은 도로 링크 데이터를 이용해 실제 도보 이동 시간을 계산했다. 이때, 보행 속도는 5km/h로 가정했다.
모형의 복잡도를 줄이고 과적합 위험을 줄이기 위해 모든 변수에 대해 랜덤 효과를 적용하지는 않았다. 본 연구에서는 수요 발생 부분과 양의 이용량 부분 모두에서 군집별 절편을 계층적으로 추정하여 건물 용도 기반 군집별 기본 수요 수준의 차이를 반영하였다. 설명 변수 중에서는 종사자 수 변수에 대해서만 랜덤 효과를 적용했으며 나머지 변수는 고정 효과를 적용했다. 종사자 수는 공간의 기능과 직접적으로 연관돼 군집별로 그 영향이 크게 다를 수 있지만, 인구나 정류장 수는 비교적 일관된 방향으로 작용할 것으로 판단했기 때문이다. 연구에서 사용한 모형의 수식은 Equations 1, 2, 3과 같다.
먼저 허들 감마 모형의 수요 발생 부분이다. 이 수식들에서는 각 격자에서 DRT 이용량이 발생하는지 여부를 설명한다. 수식에서 는 개별 100m 격자를 나타내며, 는 격자 가 속한 건물 용도 기반 군집을 의미한다. 는 격자 에서 관측된 DRT 이용량이다. 는 해당 격자에서 DRT 이용량이 0보다 큰지 여부를 나타내는 이항 변수이다. 는 격자 에서 DRT 이용량이 발생할 확률을 의미한다. 는 군집 의 발생부 절편으로 각 건물 용도 군집별 이용 발생 가능성의 차이를 나타낸다. 는 격자 의 고정 효과 설명 변수 벡터를 의미하며 와 는 각각 인구와 접근 가능한 버스 정류장 수의 고정 효과 설명 변수이다. 이때, 는 에 대응하는 고정 효과 계수 벡터이며, 는 도심에서만 접근 가능 정류장 수를 반영하기 위해 도심일 때 1, 촌락일 때 0을 나타내는 변수다. 또한, 은 랜덤 효과 설명 변수 벡터이며 본 연구에서는 종사자 수를 의미한다. 는 군집 에 대응하는 랜덤 효과 계수로 종사자 수가 DRT 수요에 미치는 영향이 군집별로 다르게 나타날 수 있음을 반영한다.
다음으로 Equations 4, 5는 이용량이 0보다 큰 격자만을 대상으로 양의 이용량 규모를 감마분포로 설명한다. 이때, 는 형상 모수 와 비율 모수 를 갖는 감마 분포를 따른다고 가정했다. 는 DRT 이용량이 발생한 조건에서의 평균 이용량을 의미한다. 평균 수요 는 로그 연결 함수를 통해 선형 예측식과 연결된다. 는 에 대응하는 고정 효과 계수 벡터이며 는 군집 에 대응하는 랜덤 효과 계수이다. 는 격자 가 속한 군집 의 절편으로 각 군집의 기본적인 수요 수준 차이를 나타낸다.
허들 감마 모형에서 최종적인 격자별 기대 수요는 이용 발생 확률과 발생 이후 조건부 평균 이용량의 곱으로 산출된다. 이를 식으로 표현하면 Equation 6과 같다.
군집별 절편과 종사자 수의 랜덤 효과는 Equations 7, 8, 9, 10과 같은 계층적 구조를 따른다.
연구자료 수집 및 기초분석
1. 연구의 범위
본 연구는 DRT 수요의 공간적 이질성을 반영하기 위해 미시 격자 단위에서 모형을 구축하였다. 읍면동과 같은 행정 구역 단위는 서로 다른 공간 기능을 하나의 단위 안에 포함할 수 있어, 수요 발생 구조를 세밀하게 파악하는 데 한계가 있다. 이에 본 연구에서는 100m 격자를 선택하여 결과를 도출했다. 회귀모형은 나주, 세종, 제주, 창원, 천안, 청주, 충주의 일부 DRT 운영지역 자료를 이용해 구축하였다. DRT 이용자료는 Studio Galilei로부터 제공받았다. Studio Galilei는 DRT 운영 플랫폼인 바로DRT를 제공하는 국내 모빌리티 플랫폼 기업이다. 분석에 사용한 DRT 승차자료의 기간은 2025년 3월부터 5월까지이다. 다만 세종시는 2024년에 해당 사업이 종료되었으므로, 2024년 3월부터 5월까지의 승차자료를 사용하였다. 이외의 설명 변수는 분석 시점과 가장 가까운 시기의 자료를 활용하였다.
2. 연구자료 수집
본 연구에서 사용한 자료는 Table 2와 같다. 분석의 공간 단위는 SGIS 통계지리정보서비스에서 제공하는 100m 격자를 사용하였으며, 인구와 종사자 수 등 격자 단위 사회경제 자료도 SGIS의 자료를 활용하였다. DRT 이용자료는 각 승차 건의 위·경도 좌표를 기준으로 100m 격자에 배정하였다. 합승이 발생한 경우에는 실제 탑승 인원수만큼 이용량을 반영하였다. 또한 격자 경계부에서 승차가 이루어질 경우 실제 수요를 유발한 격자와 관측된 승차 격자가 다를 수 있으므로, 승차 자료에 가우시안 필터를 적용하였다. 필터링 과정에서는 승차 지점과의 거리뿐 아니라 각 격자의 인구와 종사자 수를 합한 활동 규모를 함께 고려하여 인접 격자에 수요를 배분하였다. 건물 용도 기반 군집화를 위해서 2025년 2월 기준 국토지리정보원의 국가기본도 건물 자료를 사용하였다. 또한 도심 및 촌락 지역 구분을 위해 2025년 1월 기준 국토교통부 개별공시지가정보를 활용하였다.
Table 2.
Data sources used in this study
3. 기초분석
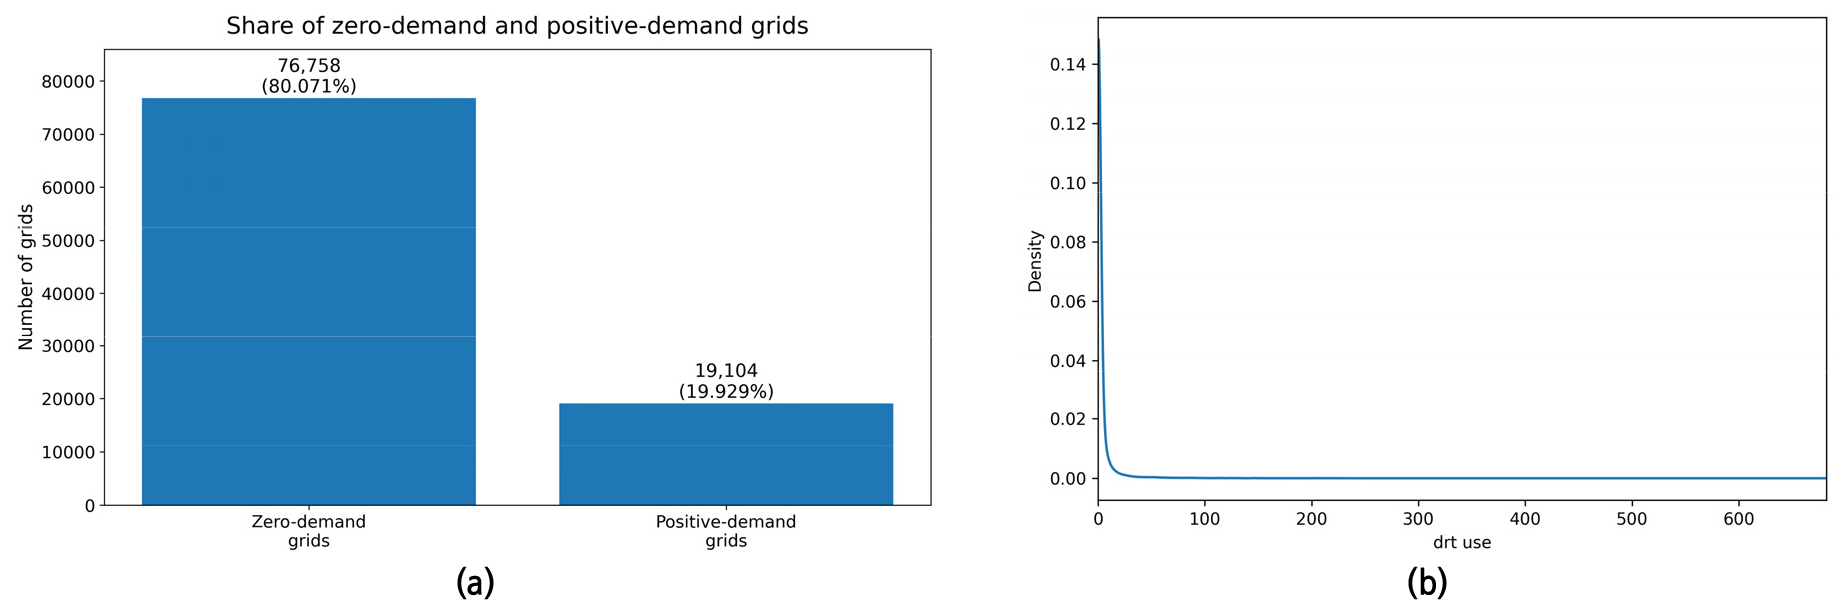
수집한 DRT 운행 지역의 이용 내역을 100m 격자 단위로 집계했으며 기초 통계는 Table 3과 같다. 전체 격자와 양의 이용량을 보인 격자를 따로 분리해 정리하였다. 추가로 이용량의 밀도 분포를 살펴보기 위해 커널 밀도 추정(Kernel Density Estimation)을 진행했고 그 결과는 Figure 4(b)와 같다. 전체 분석 격자에서 Figure 4(a)와 같이 DRT 이용량이 0인 격자가 다수를 차지하였으며, 양의 이용량이 관측된 격자에서는 낮은 값에 집중되고 일부 격자에서 매우 큰 수요가 나타나는 우측 꼬리 분포가 확인되었다. 이러한 분포 특성은 이용 발생 여부와 발생 이후 양의 이용량 규모를 분리하여 설명하는 hurdle 구조가 필요함을 시사하며, 양의 이용량 부분에는 감마분포를 적용하는 것이 적절함을 나타낸다.
Table 3.
Summary statistics of DRT demand
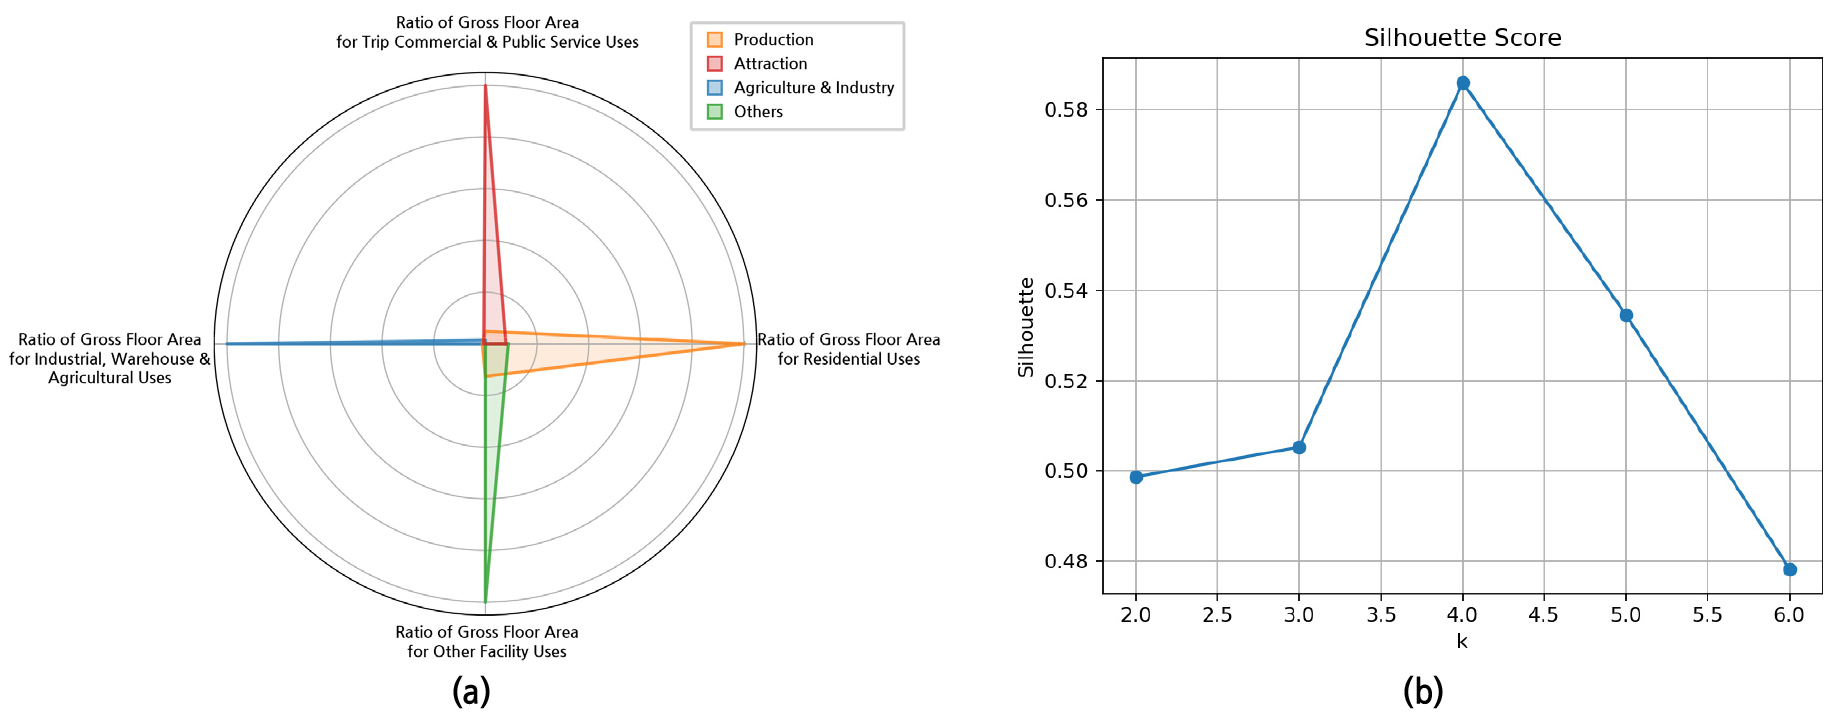
다음으로 군집화 결과를 살펴보겠다. 먼저 건물 용도별 군집화의 경우 통행생성지, 통행유인지, 농공업지, 기타 지역으로 사전에 기대한 대로 명확하게 구분됨을 확인할 수 있으며 silhouette 값을 보면 k=4일 때 0.586의 값을 보였으며 세부 내용은 Table 4와 Figure 5를 통해 확인할 수 있다.
Table 4.
Composition of Building-use clusters
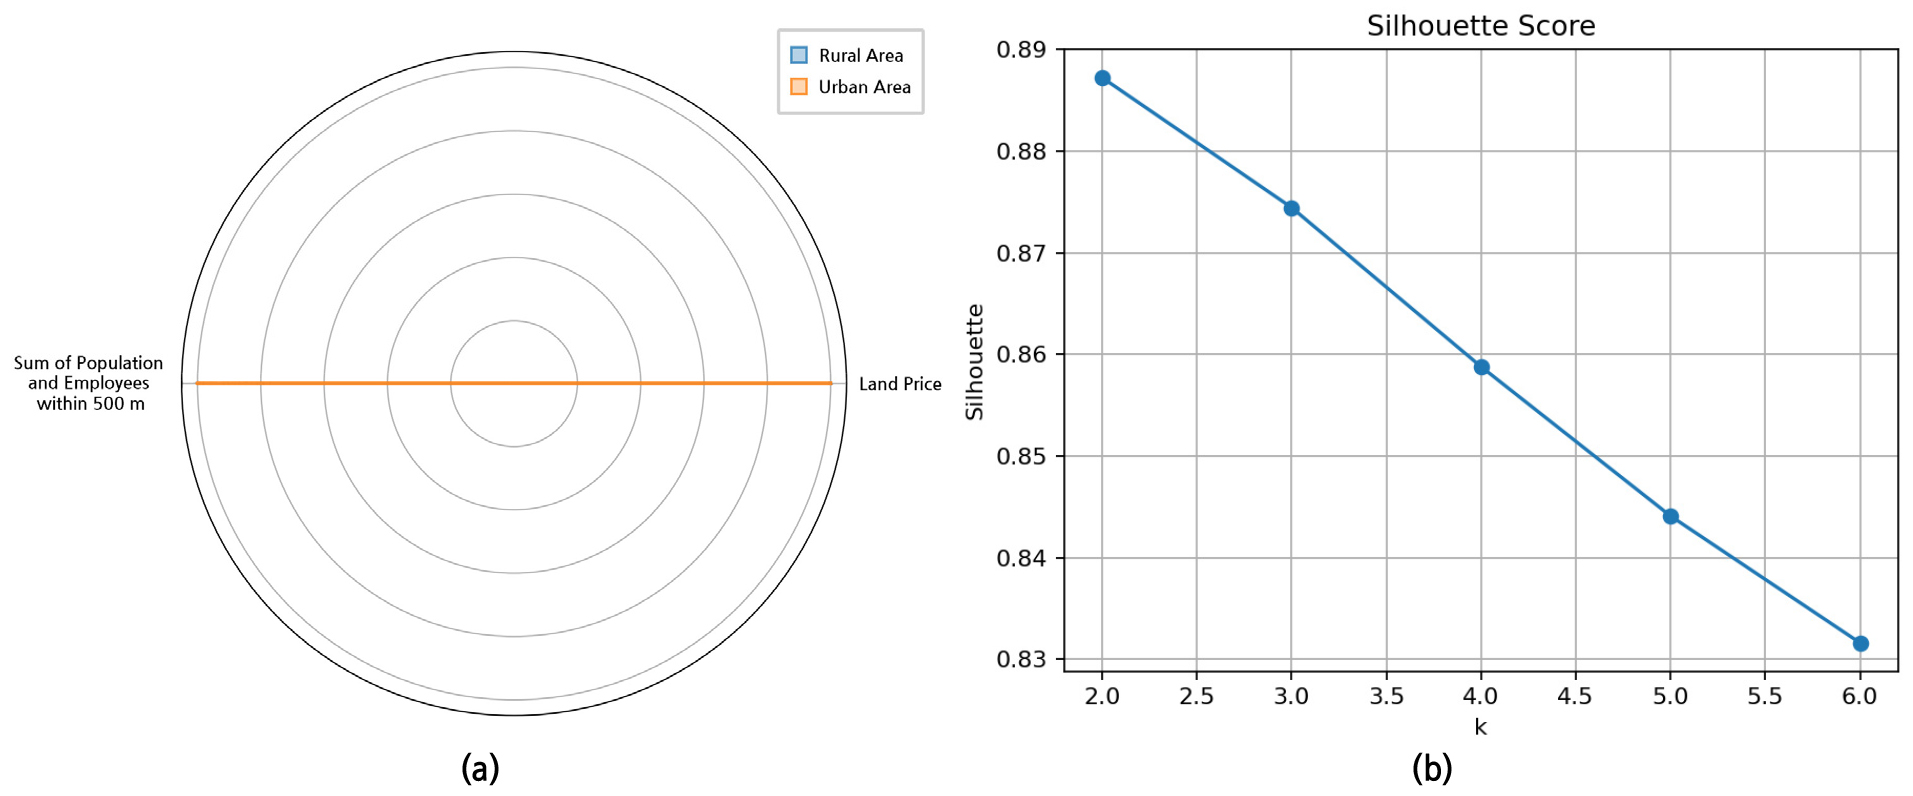
다음으로 도심/촌락 지역 군집화는 k=2일 때 0.887로 도심과 촌락 지역 두 군집으로 나뉘는 것이 가장 적합했다. 세부 내용은 Table 5와 Figure 6을 통해 확인할 수 있다.
연구에서 사용한 두 군집화에서 데이터가 존재하지 않는 격자의 경우 분석에서 제외된다. 예를 들어, 100m 격자 내 건물이 존재하지 않을 경우 모든 비율이 0이 되어 군집으로 분류되지 않으며 이 격자는 분석에서 제외된다. 이 과정에서 분류되지 않은 격자에 실제 DRT 수요가 발생했는지 확인했으며, 확인 결과 그러한 사례는 존재하지 않았다.
Table 5.
Composition of urban and rural clusters
| Land price | Sum of population and employees within 500m | |
| Rural area | 110,810 | 993 |
| Urban area | 2,715,520 | 23,412 |
본 연구에서는 100m 격자 외에도 500m, 1km 격자 단위의 분석을 함께 진행해 분석 단위를 최종 선정했다. 분석 결과, 군집화 결과에선 3가지 수준이 모두 비슷한 결과를 보였다. 군집의 변수 구조는 비슷한 양상을 보였으며 silhouette 값도 유사했다. 다만, 계층적 베이지안 모형의 결과는 달랐다. MCMC 모수 추정 결과 100m 격자 모형에서는 주요 변수의 방향성과 MCMC 수렴 역시 안정적이었으나 500m, 1km 격자 모형은 일부 계수의 불확실성이 크고 모수 추정이 불안정했다. 또한, 100m 격자 모형에서는 주요 설명 변수의 계수 방향과 군집별 계수의 상대적 크기 관계가 이론적 기대와 일관되게 나타났다. 이러한 결과는 비교적 큰 공간 단위로 모형을 구축할 경우 각 지역의 미시적 공간 특성이 평균화되어 모형이 DRT 수요의 공간적 구조를 충분히 반영하지 못할 가능성이 있음을 시사한다. 따라서 본 연구에서는 미시적 공간 구조를 보다 잘 반영하고 모형 계수의 안정성이 확보되는 100m 격자를 최종 분석 단위로 선택했다.
분석 결과
본 연구는 건물 용도 기반 군집을 활용하여 DRT 수요의 공간적 이질성을 반영하고자 했다. 각 군집별로 수요 발생 구조가 서로 다르게 나타날 것이라는 가정 아래에 계층적 베이지안 허들 감마 회귀 모형을 구축했으며, 분석 결과는 이러한 가정과 대체로 일치하는 것으로 나타났다. 모형의 분석 결과는 Table 6과 같다. 베이지안 추정 결과에 대한 해석은 사후 분포를 기반으로 산출된 95% 신용 구간을 중심으로 수행한다. 이러한 베이지안 신용 구간은 주어진 데이터를 바탕으로 실제 파라미터가 해당 구간 내에 존재할 확률이 95%임을 직접적으로 나타낸다. 따라서 특정 파라미터의 신용 구간이 0을 포함하지 않을 경우, 해당 변수가 종속변수에 미치는 효과의 방향이 비교적 명확하다는 것이며, 구간의 폭이 좁을수록 파라미터 추정의 정밀도가 높음을 의미한다. 또한, 추정 결과의 신뢰성을 확인하기 위해 MCMC 수렴 진단 지표인 , 중심부 유효 표본 수, 꼬리부 유효 표본 수를 함께 검토하였다. 은 여러 개의 MCMC chain이 동일한 사후분포에 수렴했는지를 판단하는 지표로, 1에 가까울수록 수렴이 양호함을 의미한다. 중심부 유효표본수와 꼬리부 유효표본수는 각각 사후 분포의 중심부와 양쪽 꼬리 부분을 추정하는 데 사용된 실질적인 표본 수를 의미하며, 값이 충분히 클수록 사후 평균과 95% 신용 구간이 MCMC 표본추출 오차에 크게 좌우되지 않았음을 나타낸다. 본 연구의 추정 결과 모든 모수의 은 1.001 미만(최댓값 1.000x)으로 나타났으며, 최소 중심부 유효 표본 수와 꼬리부 유효 표본 수는 각각 5,570과 3,267로 충분한 수준으로, 모수 추정 결과는 안정적인 사후표본에 기반한 것으로 판단된다.
Table 6.
Parameter estimates of the hierarchical Bayesian hurdle gamma regression model: (a) occurrence part and (b) positive-demand part
먼저 수요 발생 부분의 군집별 절편을 살펴보면, 전체 절편의 평균은 -3.025로 나타났으며 군집 간 절편의 표준편차는 0.532로 추정되었다. 이는 DRT 수요 발생 가능성이 전반적으로 낮게 나타남을 의미한다. 또한, 군집 간 절편에서 모두 차이를 보였고, 이는 건물 용도 기반 공간 기능에 따라 기본적인 수요 발생 가능성이 다르게 나타남을 보여준다.
수요 발생 부분의 고정 효과를 살펴보면 인구의 계수가 1.147로 추정돼 인구가 많을수록 DRT 수요가 발생할 확률이 높아짐을 보였다. 접근 가능한 버스 정류장 수는 계수가 0.044로 추정됐으나 95% 신용 구간 내에 0을 포함해 접근 가능한 버스 정류장 수가 DRT 수요 발생 여부에 어떠한 영향을 미치는지는 특정할 수 없는 것으로 나타났다.
종사자 수 변수는 군집별 랜덤 효과로 모형에 포함됐으며, 모든 군집에서 양의 효과를 보였다. 통행유인지에서는 종사자 수의 계수가 0.8로 나타났으며 농공업지에서는 0.904, 기타 지역에서는 0.818로 나타났다. 반면, 통행생성지에서는 0.553으로 상대적으로 낮은 값을 보였다. 이는 종사자 수가 많은 격자일수록 DRT 수요가 발생할 가능성이 높아지지만, 그 영향의 크기는 공간 기능에 따라 다르게 나타남을 의미한다. 특히, 인구 수가 적고 대부분이 종사자 수로 이뤄지는 공간에서 종사자 수가 DRT 수요 발생 확률에 더 많은 영향력을 미치는 것으로 해석할 수 있다.
다음으로 양의 이용량 부분을 살펴보면, 전체 절편 평균은 –1.465로 나타났으며 군집 간 절편의 표준편차는 0.309로 추정되었다. 감마분포의 형상 모수는 0.306으로 추정되었다. 형상 모수가 1보다 작은 값으로 나타난 것은 양의 이용량 분포가 낮은 값에 집중되어 있으면서도 일부 격자에서 매우 큰 수요가 발생하는 우측 꼬리 분포를 가진다는 것을 의미한다. 이는 기초 통계에서 확인된 높은 왜도 및 첨도 값과 일치한다.
양의 이용량 부분의 고정 효과를 살펴보면, 인구 계수는 0.561로 나타났으며 접근 가능한 버스 정류장 수 계수는 –0.213으로 나타났다. 이는 인구가 많을수록 DRT 수요가 높고, 접근 가능한 버스 정류장 수가 많을수록 대체 수단이 많아 DRT 수요가 낮을 것이라는 기존 가정에 부합한다.
양의 이용량 부분의 종사자 수 랜덤 효과 역시 모든 군집에서 양의 값을 보였다. 종사자 수 계수는 통행유인지에서 0.808로 가장 크게 나타났으며, 기타 지역 0.67, 농공업지 0.641, 통행생성지 0.594 순으로 나타났다. 이는 고용 및 활동 집중도가 높은 공간에서 종사자 수가 이용량 규모를 증가시키는 효과가 가장 크다는 것을 의미한다. 반면, 통행생성지에서는 상대적으로 낮은 계수가 나타났고 주거 중심 공간에서는 종사자 수가 이용량 규모에 미치는 영향이 상대적으로 제한적임을 시사한다.
모형의 예측 성능을 살펴보면, 100m 격자 단위에서 실제 DRT 이용량의 평균은 0.65였으며 모형의 예측 평균은 0.81로 나타났다. 평균 절대 오차는 0.99였으며 극단값을 제외한 5%~95% 범위에서는 0.22로 나타났다. 이는 미시 격자 단위에서 평균 이용량이 0.65 수준으로 매우 작은 값인 반면, 일부 격자에서는 상대적으로 큰 수요가 발생하는 우측 편향 분포가 나타나기 때문으로 해석할 수 있다. 이러한 분포에서는 소수의 고수요 지역에서 발생하는 예측 오차가 평균 절대 오차를 크게 증가시키는 경향이 있어 개별 격자의 절대적인 수요 규모를 정확히 예측하는 데에는 구조적인 한계가 존재한다. 이러한 결과는 서론 및 선행 연구에서 논의한 바와 같이, 교통 수요 예측이 가지는 불확실성과 일치한다.
따라서 본 연구에서는 이러한 한계를 보완하고 정책적 의사결정에서의 활용 가능성을 고려하여 순위 기반 평가 지표를 함께 활용했다. 분석 결과, 100m 격자 단위에서 상위 10% 지역을 41.85%, 상위 30% 지역을 62.40%의 비율로 식별하였으며 Spearman 순위상관계수는 0.58로 나타났다. 이러한 모형의 결과는 Table 7과 같다.
본 연구에서는 국지적 공간 특성을 반영하기 위해 100m 격자를 기본 분석 단위로 설정하였다. 다만, 이러한 미시 격자 단위에서는 위치나 격자 경계에 따른 오차, 희소 수요의 우연적 변동으로 인한 오차 등의 랜덤 노이즈가 발생할 수 있다. 따라서 이러한 오차를 완화하기 위해 500m, 1km 격자 단위, 읍면동 단위로 결과를 집계하여 살펴보았다. 그 결과, 집계 단위가 커질수록 가중 절대 백분율 오차(Weighted Absolute Percentage Error, WAPE) 지표가 개선되는 경향을 보였다. WAPE는 전체 실제 수요량 대비 예측 절대 오차의 비율을 나타내는 지표이다. MAE는 집계 단위가 커질수록 수요 규모 자체가 커져 단위 간 직접 비교가 어려우나 WAPE는 수요 규모를 반영하기에 직접적인 비교가 가능하다. 집계 단위가 커질수록 WAPE는 개선됐지만, Spearman 순위상관계수 등 순위 기반 성능은 일관되게 개선되지 않았다. 이는 랜덤 노이즈 감소 효과로 절대적 지표는 개선됐지만, 순위와 같은 상대 지표는 랜덤 노이즈 감소가 지표 개선에 큰 효과가 없어 비슷한 값을 보인 것으로 해석된다.
Table 7.
Model performance comparison
모형의 지역 간 전이 가능성을 검증하기 위해 leave-one-region-out 교차검증을 수행했다. leave-one-region-out 교차검증은 전체 운영 지역 중 하나의 지역을 검증 지역으로 제외하고 나머지 운영 지역의 자료만을 이용해 모형을 추정한 뒤, 제외된 지역의 DRT 수요를 예측하는 방식으로 이뤄진다. 본 연구에서는 나주, 세종, 제주, 창원, 천안, 청주, 충주의 운영 지역을 기준으로 하므로 총 7번의 반복을 통해 각 지역의 데이터를 제외하고 모형 추정 후 해당 지역의 수요를 예측 및 실제 값과 비교하는 식으로 진행된다. 검증 결과는 Table 8과 같다.
Table 8.
Leave-one-region-out cross-validation results
교차검증 결과, 100m 격자 단위의 순위 기반 성능은 일정 수준 유지되었다. 모든 지역에서 Spearman 순위상관계수는 양의 값을 보였고, Top 30% hit rate 역시 무작위 기준인 30%를 상회하였다. 반면, 지역별 총수요 예측에서는 과대 및 과소 추정을 보였다. 특히 제주, 충주 등의 지역에서는 약 5~10배 과대 추정했다. 이는 본 모형을 다른 지역에 전이하여 적용할 때, 지역별 총수요를 직접 추정하는 데에는 한계가 있을 수 있음을 보여준다. 다만, 이는 교차검증 결과로 최종 모형은 아니기에 최종 모형에 비해 예측 결과가 상대적으로 불안정하게 나올 수 있다. 실제로 충주나 제주와 같이 자료 비중이 큰 지역을 제외한 경우 모수 추정간 발산 전이가 발생하고 일부 계수가 신용 구간에 0을 포함하는 것이 확인되었다. 이는 운영 데이터 부족 문제가 존재함에도 교차검증을 위해 데이터를 더 제외하면서 데이터 부족 문제가 심화돼 안정적인 모형 및 모수 추정을 어렵게 만든 것으로 판단된다. 또한, 운영 경계를 행정 구역 단위로 근사하였기에 실제 DRT가 운영되는 격자가 아님에도 분석 대상지로 포함될 수 있다. 따라서 모형의 예측값에는 DRT 비운영 격자의 잠재 수요가 포함될 수 있고 이러한 오차가 누적돼 지역 총수요가 과대 추정될 수 있다.
추가로 모형 잔차의 공간 자기상관을 검토하기 위해 Moran’s I 분석을 수행하였다. 본 연구에서 사용한 모형의 최종 기대수요 잔차에 대한 Moran’s I는 Queen 인접 기준 0.291, k-nearest neighbor 기준 0.284로 나타났으며, 두 경우 모두 p-value는 0.001로 유의하였다. 이는 여전히 잔차에 유의한 양의 공간 자기상관이 남아 있음을 의미한다.
다만, 동일한 자료에 대해 계층 구조를 제거한 단순 베이지안 허들 감마 회귀 모형을 적용한 경우 Moran’s I 값은 Queen 인접 기준 0.444, k-nearest neighbor 기준 0.436으로 나타났다. 계층 구조를 포함한 모형에서 Moran’s I 값이 감소한 것은 미시 격자 분석 및 건물 용도 기반 군집화를 통해 특정 지역에 국한된 수요 차이가 아니라 전역적으로 나타나는 공간 기능의 차이를 모형에 반영함으로써, 지역 간 공간 이질성의 일부가 설명되었음을 의미한다. 즉, 공간의 기능적 구조 차이에 따라 나타나는 DRT 수요 패턴을 모형이 일부 설명하면서 잔차에 남는 공간 패턴이 감소한 것으로 해석할 수 있다. 그러나 여전히 잔차에 양의 공간 자기상관이 존재하므로 본 연구에서는 공간 자기상관이 예측 결과의 해석에 미치는 영향을 고려하여, 개별 격자의 절대 수요량을 확정적으로 해석하기보다 고수요 후보 지역을 식별하기 위한 상대적 수요 지표로 예측 결과를 제시하였다.
공간 자기상관 문제를 해결하기 위해 인접 격자 간 공간 의존성을 직접 반영하는 공간 자기회귀 모형이나 조건부 자기회귀 모형 등의 방식을 쓸 수도 있을 것이다. 공간 자기회귀 모형(Spatial Autoregressive Model, SAR)은 인접 지역의 종속변수가 해당 지역의 종속변수에 직접 영향을 미치는 구조를 가정하는 모형이며, 조건부 자기회귀 모형(Conditional Autoregressive Model, CAR)은 인접 지역 간 확률적 의존성을 반영하여 공간적으로 가까운 지역의 값이 서로 유사하게 나타나도록 모형화하는 방식이다. 그러나 본 연구의 목적은 제한된 운영 지역 자료를 이용해 전국 100m 격자 단위로 전이 가능한 수요 구조를 추정하는 데 있다. 이 경우 관측 운영 지역 내부에서 추정된 공간 의존 구조를 미운영 지역까지 동일하게 적용해야 하는 강한 가정이 필요하며, 공간효과가 지역 고유의 미관측 특성을 흡수할 경우 인구, 종사자 수, 대중교통 접근성, 건물 용도 군집과 같은 설명 변수의 정책적 해석 가능성도 약화될 수 있다.
이에 본 연구는 공간 효과를 직접 포함하기보다 잔차 Moran’s I를 통해 공간 자기상관의 존재를 진단하고, 그 영향을 예측 결과 해석에 반영하였다. 즉, 본 모형은 개별 격자의 절대 수요량을 정밀하게 예측하는 완결적 공간 예측 모형이라기보다, 전국 단위에서 DRT 이용 수요가 높은 후보 지역을 선별하기 위한 해석 가능한 정책 지원 모형으로 보는 것이 타당하다. 향후 연구에서는 본 연구에서 확인된 잔차 공간 의존성을 바탕으로 공간 랜덤 효과 또는 CAR/SAR 계열 모형을 적용한 확장 모형을 검토할 필요가 있다.
본 연구에서 제안한 모형을 이용해 100m 격자 단위의 DRT 이용 수요를 추정하였다. 본 모형은 농어촌 및 중소도시형 DRT 운영 맥락을 대상으로 구축되었으며, Figure 7(a)는 동일한 설명 변수 체계를 전국 100m 격자에 적용했을 때의 예측 결과를 보여준다. 시각화 결과, 인구 및 종사자 수가 집중된 수도권과 주요 도시 주변에서도 상대적으로 높은 예측값이 나타났다. 이는 활동 규모가 큰 지역에서 잠재적 이동 수요가 높게 산출되는 모형 구조를 반영한 결과이다. 그러나 고밀 대도시 지역의 DRT 이용 행태는 농어촌 및 중소도시형 운영지역과 다를 수 있으므로, 해당 지역의 예측값은 실제 도입 판단을 위한 확정적 수요량이 아니라 추가 검증이 필요한 참고 지표로 해석해야 한다.
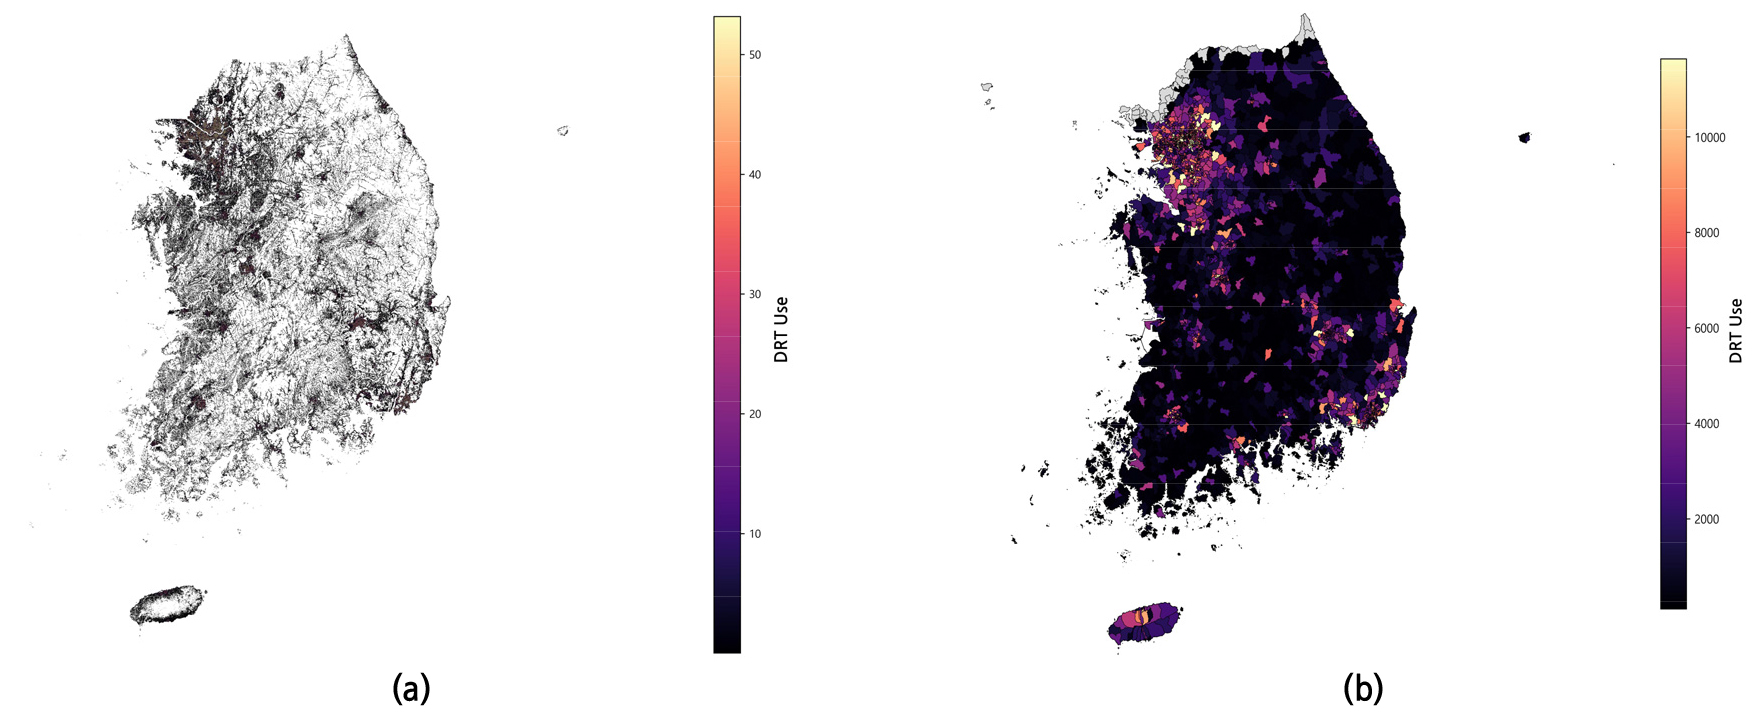
또한, 정책적 해석을 위해 격자 단위 결과를 읍면동 단위로 집계한 결과는 Figure 7(b)와 같다. 미시 단위 분석에서 발생할 수 있는 일부 예측 오차가 공간 집계 과정에서 완화되면서 지역 간 상대적인 수요 패턴이 보다 명확하게 나타나는 것을 확인할 수 있다.
결론
본 연구는 제한된 DRT 운영 데이터를 활용하여 전국 농어촌 및 중소도시의 이용 수요 구조를 추정하기 위한 분석 틀을 제시했다. 이를 위해 전국을 100m 격자 단위로 구분하고 건물 용도 기반 군집화를 통해 공간의 기능적 특성을 반영했다. 이후 각 군집의 특성을 계층 구조로 반영한 계층적 베이지안 허들 감마 회귀 모형을 구축하여 DRT 수요 발생 구조를 추정했다.
분석 결과, 인구 규모는 DRT 수요 발생 여부와 양의 이용량 규모 모두에서 양의 관계를 보였다. 종사자 수 역시 모든 건물 용도 군집에서 양의 효과를 보였으나, 그 영향의 크기는 공간 기능에 따라 다르게 나타났다. 통행유인지와 같이 고용 밀도가 높은 지역에서는 종사자 수가 중요한 수요 결정 요인으로 작용하는 반면 주거 중심 지역에서는 그 영향이 상대적으로 제한적인 것으로 나타났다. 이러한 결과는 공간의 기능적 특성에 따라 교통 수요 발생 구조가 달라질 수 있음을 시사한다. 접근 가능한 버스 정류장 수의 경우, 수요 발생 여부에 대해서는 95% 신용 구간에 0을 포함하여 통계적으로 명확한 효과가 확인되지 않았다. 반면, 양의 이용량 부분에서는 음의 방향으로 추정되어 DRT 이용이 발생한 격자 내에서는 접근 가능한 정류장이 많을수록 DRT 이용량 규모가 낮게 나타나는 것을 확인할 수 있었다.
모형의 예측 성능을 순위 기반 지표로 평가한 결과, 미시 격자 단위에서도 고수요 지역을 일정 수준 이상 식별할 수 있는 것으로 나타났다. 또한, 100m 격자 단위 예측값을 500m, 1km, 읍면동 단위로 집계하여 평가한 결과, WAPE가 집계 단위가 커질수록 개선되는 경향을 보였다. 이는 미시 격자 단위에서 발생하는 랜덤 노이즈가 공간 집계 과정에서 일부 완화될 수 있음을 시사한다. 모형의 지역 간 전이 가능성을 검토하기 위해 Leave-one-region-out 교차검증을 수행한 결과, 지역별 총수요 예측에는 과소 또는 과대 추정이 나타났으나, 100m 격자 단위의 순위 기반 성능은 일정 수준 유지되었다. 이는 정책적 의사결정 수준에서 DRT 도입 우선 지역을 선정하는 데 본 모형이 실질적인 활용 가능성을 가질 수 있음을 의미한다.
본 연구는 제한된 지역의 운영 데이터를 기반으로 전국 농어촌 및 중소도시형 DRT 이용 수요 구조를 전국 미시 격자 단위에서 추정할 수 있는 방법론을 제시했다는 점에서 의의가 있다. 이러한 접근은 신규 DRT 사업 지역 선정이나 차량 배치 계획 수립과 같은 정책적 의사결정을 지원하는 데 활용될 수 있을 것으로 기대된다.
다만, 본 연구에는 몇 가지 한계가 존재한다. 첫째, 정확한 DRT 운영 경계가 제공되지 않아 운영 행정 구역을 서비스 가능 영역으로 근사하였다. 이로 인해 실제 서비스 영향권 밖의 격자가 분석 대상에 포함되거나, 반대로 실제 서비스 영향권 일부가 충분히 반영되지 않았을 가능성이 있다. 둘째, 본 연구에서 활용한 접근 가능한 버스 정류장 수는 전국 단위에서 일관적으로 구축 가능한 변수라는 장점이 있으나, 실제 운행횟수나 배차간격을 반영하지 못한다. 향후 연구에서는 정류장별 운행빈도, 배차간격, 시간대별 서비스 수준을 반영한 대중교통 접근성 지표를 구축할 필요가 있다. 셋째, 모형 잔차에서 유의한 공간 자기상관이 확인되었으므로, 인접 격자 간 공유되는 미관측 공간 요인이 여전히 남아 있음을 고려해야 한다. 향후 연구에서는 공간 랜덤 효과 또는 CAR/SAR 계열 모형을 포함한 확장 모형을 검토할 필요가 있다. 마지막으로 본 연구의 학습자료는 농어촌 및 중소도시형 DRT 운영지역을 중심으로 구성되어 있어 고밀 대도시 지역의 수요 구조를 충분히 반영하지 못한다. 따라서 향후 연구에서는 수도권 및 광역시 등 대도시형 DRT 운영 자료를 추가로 확보하여 도시 규모와 교통공급 수준에 따른 수요 구조 차이를 검증할 필요가 있다.